你的TensorFlow模型在CPU上推理要12秒,能不能塞进FPGA做到毫秒级响应?答案是能,但代价比多数人想象的大。
先搞清一个前提:你真正要解决什么问题
TensorFlow本身是软件框架,运行在CPU/GPU上。把它放到FPGA上,本质是模型推理加速——将训练好的权重"烧"进硬件电路,用并行计算代替串行迭代。这不是"把Python代码搬上去",而是重新设计数据通路与计算单元。
关键约束:
量化位宽:片上BRAM/LUT资源有限,通常需将FP32权重降至INT8甚至INT4,精度损失须在可接受范围内
算子映射:卷积、全连接、激活函数各自需要定制硬件IP核,没有通用"TensorFlow-to-FPGA"一键工具链
数据流设计:需手写或生成HLS代码,处理权重加载、特征图缓存与流水级数
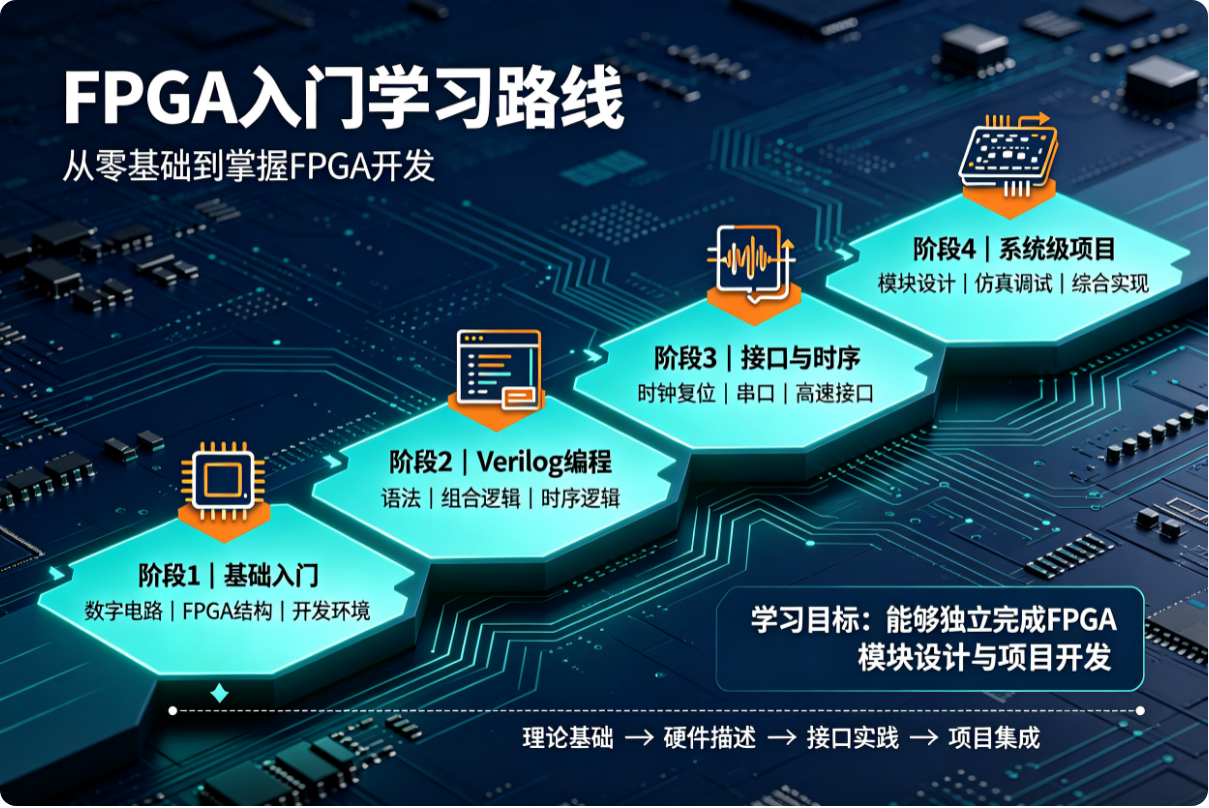
目前较成熟的路径是:TensorFlow → ONNX → 量化 → HLS(C++)或Verilog → 综合 → FPGA。参考IEEE Transactions on Circuits and Systems II(2023)关于INT8量化推理的综合综述,量化后模型在FPGA上可实现3~8倍吞吐提升,但面积开销约为同代GPU方案的5~15倍。
Q:FPGA部署TensorFlow模型,最低需要多大的逻辑资源?
以ResNet-18 INT8量化为例,Virtex UltraScale+ VU9P(约2000万LUT)可承载完整推理电路,单帧延迟约1.2 ms。若换为轻量级MobileNetV2(INT8),Kintex-7级别器件(约500万LUT)即可运行,但批处理深度受限。建议先用HLS仿真跑资源报告再定器件型号,不要凭经验拍脑袋。
Q:和直接用GPU或ASIC推理相比,FPGA的优势到底在哪?
核心优势是可重构性+确定性延迟。GPU架构固定,改算子要等厂商发驱动;ASIC灵活度最差但面积最优。FPGA折中:可根据实际模型结构裁剪电路,砍掉用不到的通道与层,做到"按需取用"。代价是开发周期明显更长,工具链成熟度不及现有深度学习框架生态。
总结与思考题
把模型"压"进FPGA,本质是精度、资源、开发周期三者的博弈,没有免费午餐,只有最合适的取舍。
思考题:如果你的模型每6个月迭代一次网络结构,你会选FPGA还是换用支持在线重加载的架构?为什么?
进一步沟通
如果你正在评估一个具体TensorFlow模型上FPGA的可行性——量化方案、资源估算、HLS开发节奏——欢迎通过官网右下角的会话窗口把模型结构与目标延迟发过来。我们这边可以帮你做一份初步的硬件适配分析,不套模板,直接对着你的网络结构聊。
未经许可,禁止转载!